[ 선착순 쿠폰 발급 시스템 ] 10,000건 동시 요청 시 latency를 47초에서 2초로 개선하기
[ 지난 글 ]
지난 글에서는 GCP 서버 한대로 10,000건의 동시 요청을 처리하도록 만들었습니다. 하지만 latency가 너무 느렸기 때문에 이번 글은 latency를 개선하는 과정이 되겠습니다.
[ Redis 도입 ]
현재 시스템은 요청당 하나의 워커 쓰레드(Worker Thread)를 할당하는 구조입니다. 이 방식은 DB 쿼리 실행 시 해당 쓰레드가 응답을 받을 때까지 멈춰있는 블로킹(Blocking) 발생하여 latency가 느려지는 가장 큰 원인입니다. 설정된 200개의 쓰레드가 모두 DB 응답을 기다리며 묶이게 되면, maxConnections를 늘려 연결에 성공한 201번째 이후의 요청들은 일할 쓰레드를 할당받지 못해 대기하게 되고, 결과적으로 시스템 전체의 latency이 급격히 증가하기 때문입니다.
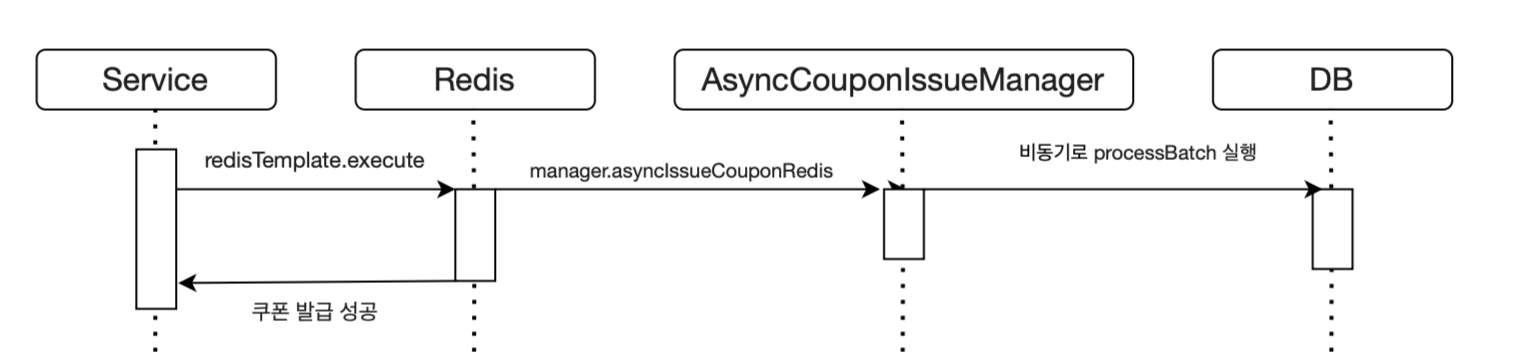
이를 해결하기 위해 DB 요청 부분을 비동기 처리하여 쓰레드의 점유 시간을 최소화하는 방안을 생각하였습니다. 특히 쿠폰 발급 여부 확인과 잔여 수량 차감이라는 핵심 로직을 반드시 DB에서 처리할 필요가 없다고 생각하였고, DB 대신 메모리 기반으로 동작하며 race condition을 원자적으로 제어할 수 있는 Redis의 Lua 스크립트를 도입을 하였습니다. Redis가 앞단에서 발급 가능 여부를 빠르게 검증하고 수량을 먼저 차감한 뒤, 실제 DB 저장은 비동기로 처리함으로써 응답 속도를 개선하고자 하고자 하였습니다.
아래는 앞서 정의한 아키텍처를 기준으로 주요 유스케이스의 처리를 나타낸 시퀀스 다이어그램입니다.
# Service
    public String issueCouponRedis(IssueCouponDto issueCouponDto) {

        /** 반환 값에 따른 의미
         *  1 : 쿠폰 발급 성공
         * -1 : 이미 발급된 유저
         * -2 : 쿠폰 소진
         * */
        String script = """
                if redis.call('SISMEMBER', KEYS[2], ARGV[1]) == 1 then
                    return -1
                end
                local count = tonumber(redis.call('GET', KEYS[1]))
                if not count or count <= 0 then
                    return -2
                end
                redis.call('DECR', KEYS[1])
                redis.call('SADD', KEYS[2], ARGV[1])
                return 1
            """;

        Long result = redisTemplate.execute(
                new DefaultRedisScript<>(script,Long.class),
                List.of("coupons","issued_users"),
                issueCouponDto.getUserId()
        );

        if(result > 0) {
            // 쿠폰발급매니저가 가진 queue에 넘겨주기
            manager.asyncIssueCouponRedis(issueCouponDto);
            return "쿠폰 발급 성공";
        } else if(result == -1) {
            return "이미 발급됨";
        } else {
            return "발급 실패";
        }
    }
# AsyncCouponIssueManager
    private final BlockingQueue<IssueCouponDto> queue = new LinkedBlockingQueue<>(10000);
    private final ExecutorService executor = Executors.newSingleThreadExecutor();
    private final CouponRepository couponRepository;
    private final JdbcTemplate jdbcTemplate;

    @PostConstruct
    public void start() {
        executor.submit(this::processBatch);
    }

    private void processBatch() {
        log.info("processBatch 실행");
        while (!Thread.currentThread().isInterrupted()) {
            try {
                // 1. 해당 큐에서 데이터 하나를 대기하며 가져옴
                IssueCouponDto firstElement = queue.poll(1, TimeUnit.SECONDS);
                if (firstElement == null) continue;

                // 2. 나머지 데이터들을 한꺼번에 긁어옴 (Batch 단위)
                List<IssueCouponDto> batch = new ArrayList<>(2000);
                batch.add(firstElement);
                queue.drainTo(batch, 1999);

                // 3. JPA saveAll 대신 JdbcTemplate 실전 Bulk Insert
                String sql = "INSERT INTO coupon_issue_history (user_id, coupon_id, issued_quantity) VALUES (?, ?, 1)";

                jdbcTemplate.batchUpdate(sql, new BatchPreparedStatementSetter() {
                    @Override
                    public void setValues(PreparedStatement ps, int i) throws SQLException {
                        ps.setString(1, batch.get(i).getUserId());
                        ps.setString(2, batch.get(i).getCouponId());
                    }
                    @Override
                    public int getBatchSize() {
                        return batch.size();
                    }
                });

                // 4. 재고 차감 (이미 메모리에서 깎았으므로 DB 반영은 한 번에)
                couponRepository.decreaseCounts(batch.get(0).getCouponId(), batch.size());

                log.info("쿠폰 {}개 차감 실행 완료",batch.size());

            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
                break;
            } catch (Exception e) {
                log.error("Batch 처리 중 에러 발생", e);
            }
        }
    }

테스트 결과, 요청의 95% latency가 약 23초에서 4.7초로 크게 개선되었음을 확인할 수 있었습니다.
하지만 여전히 사용자 경험 측면에서는 추가적인 개선이 필요한 수준입니다. 왜냐하면 구글 리서치 자료에 따르면 모바일 웹 사이트의 로딩 시간이 3초 이상일 때 32%, 5초 이상은 90%, 6초 이상은 106% 마지막으로 10초가 넘으면 123%의 이탈률이 발생한다하기 때문입니다. 따라서사용자 경험을 실질적으로 개선하기 위해 95% latency를 3초 이내로 단축하는 것을 목표로 설정하였습니다.
latency 개선을 위해 가장 먼저 was 스케일 업을 검토하였습니다. 왜냐하면 cpu사용률이 100%를 초과하는 구간이 확인되었고, 이를 통해 cpu가 주요 병목 지점이라고 판단하였기 때문입니다. 이에 따라 cpu 코어를 1개 추가한 후 테스트를 진행하였습니다.
1. was 스케일 업(코어 1개 추가)
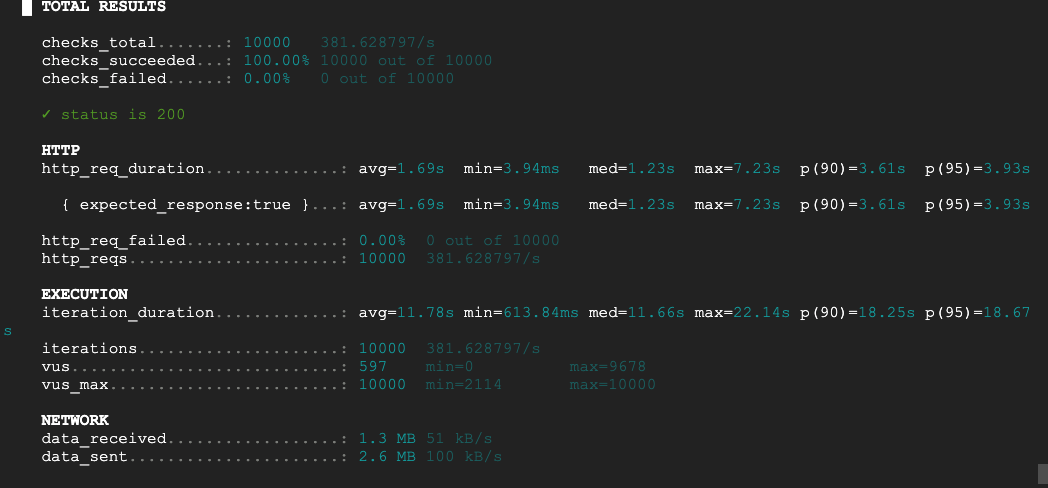
스케일 업을 통해 latency를 4.7초에서 3.93초까지 단축할 수 있었으나, 목표로 설정한 2초 이내에는 여전히 도달하지 못했습니다. 또한 CPU 사용률이 여전히 높은 수준을 유지하고 있어, 단일 WAS의 성능 개선만으로는 한계가 있다고 판단하였습니다.
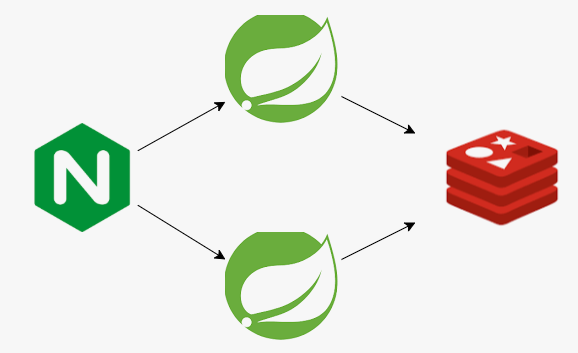
이에 따라 트래픽을 분산하기 위한 수평 확장(Scale-out)을 적용하기로 하였으며, 앞단에 L4 로드밸런서를 구성하였습니다. 이를 위해 Nginx의 stream 모듈을 활용하여 TCP 레벨에서 요청을 분산하도록 구성하였습니다.
해당 방식은 애플리케이션 레벨(L7) 처리 없이 TCP 연결 단에서 트래픽을 분산할 수 있어, 추가적인 처리 오버헤드 없이 빠른 로드밸런싱이 가능하다는 장점이 있습니다.
구성은 Nginx를 L4 로드밸런서로 두고, 스케일 업 전과 동일한 스펙의 was인스턴스를 두 대로 확장하여 트래픽을 분산하도록 하였으며, 해당 환경에서 성능 테스트를 진행하였습니다.
2. Nginx L4 로드밸런서 + was 두 대(스케일 업 전)
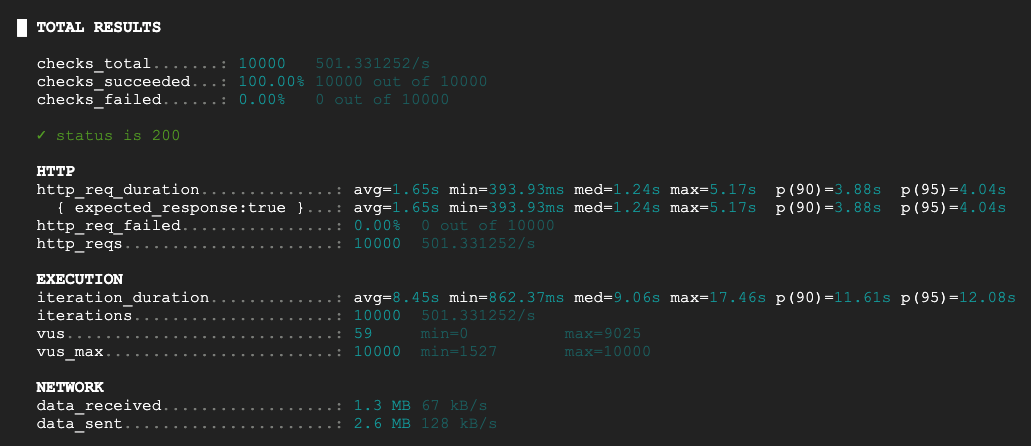
하지만 테스트 결과, latency가 3.93초에서 4.04초로 오히려 소폭 증가하는 현상이 확인되었습니다.
스케일 아웃 이후에도 성능이 개선되지 않고 오히려 악화된 점을 고려했을 때, was가 아닌 앞단의 로드밸런서 구간에서 병목이 발생하고 있을 가능성을 의심하였습니다. 특히 트래픽이 증가한 상황에서 Nginx를 통한 TCP 레벨 분산 과정에서 추가적인 오버헤드가 발생할 수 있다고 판단하였습니다.
이에 따라 로드밸런서 자체의 처리 성능이 영향을 미치는지 확인하기 위해 Nginx 인스턴스를 스케일 업하여 테스트를 추가로 수행하였습니다.
3. Nginx 스케일 업(core 1개 추가)

Nginx 스케일 업 이후 latency는 3.31초까지 개선되었으나, 여전히 목표치인 3초 이내에는 도달하지 못하였습니다.
이에 따라 로드밸런서 단의 최적화 효과는 제한적이라고 판단하였고, 남아있는 병목이 WAS 처리 성능에 있을 가능성을 다시 검토하였습니다. 따라서 was는 기존과 동일하게 2대 구성을 유지한 상태에서, 각 인스턴스의 CPU 코어를 1개씩 추가하여 스케일 업을 수행한 뒤 성능 테스트를 진행하였습니다.
4. Nginx & was 2대 스케일 업(각각 core 1개씩 추가)
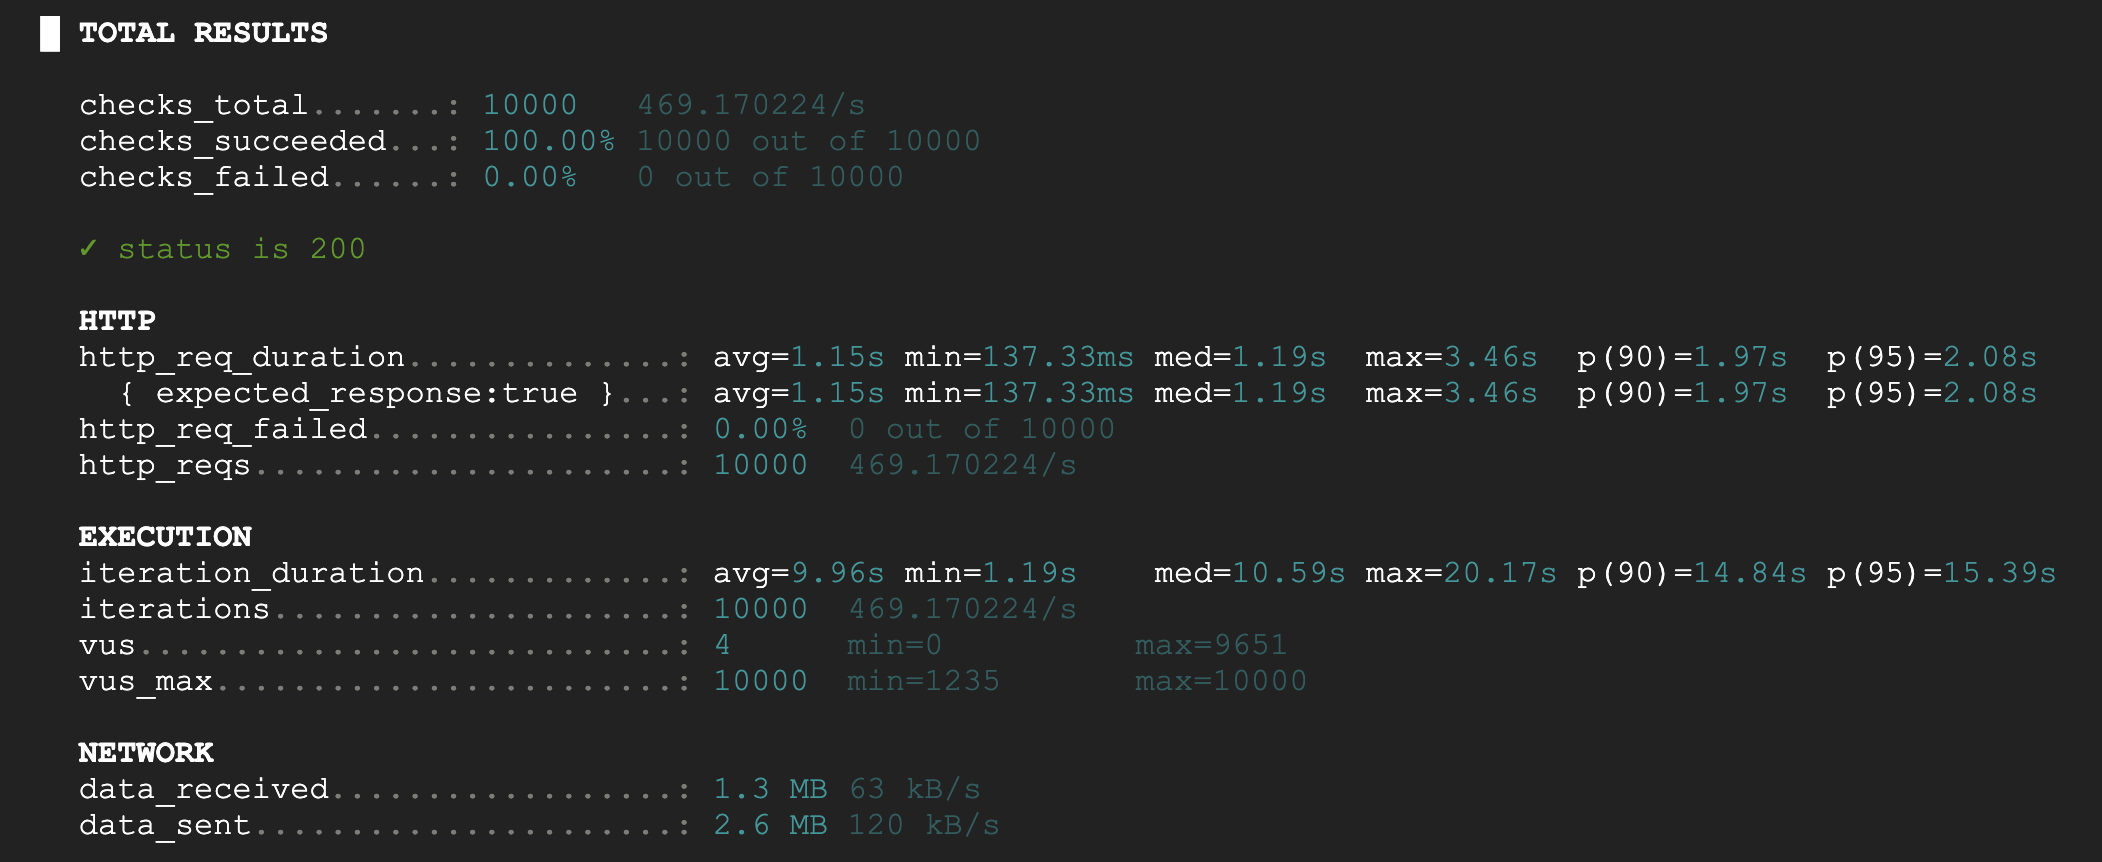
드디어 95% latency는 2.08초까지 개선되는 결과를 얻을 수 있었습니다.
추가적으로 WAS 확장 및 캐시 계층 스케일 업 등을 통해 더 많은 성능 개선 여지를 검증하고자 하였으나, Google Cloud 무료 크레딧 환경에서 제공되는 CPU quota 제한으로 인해 추가적인 부하 테스트는 진행하지 못하였습니다.
그럼에도 불구하고, 여러 단계의 구조 개선과 스케일 조정을 통해 latency를 초기 대비 큰 폭으로 개선하였으며, 유의미한 성능 개선을 확인할 수 있었습니다.
[ 회고 ]
최근 채용 공고들을 보면 “대규모 트래픽 처리 경험”이 우대 사항으로 자주 등장합니다. 하지만 현재 재직 중인 환경에서는 이러한 규모의 트래픽을 직접 경험하기 어려워, 대규모 트래픽을 어떻게 처리하는지에 대한 궁금증을 지속적으로 가지고 있었습니다. 이번 개인 프로젝트를 통해 대규모 트래픽 처리는 단순히 서버 성능을 높이는 것만으로 해결되는 문제가 아니라는 점을 직접 경험할 수 있었습니다.
2월 초부터 약 3개월 동안 프로젝트에 깊이 몰입하며 성능 개선을 시도했지만, 예상하지 못한 다양한 병목과 문제들을 마주하게 되었습니다. 이 과정에서 여러 번 한계에 부딪히며 포기하고 싶은 순간도 있었지만, 문제는 반드시 해결할 수 있다는 믿음을 바탕으로 지속적으로 학습하고 원인을 분석하며 하나씩 해결해 나갔습니다.
그 결과, 단순한 성능 개선을 넘어 시스템 구조와 트래픽 처리 방식 전반에 대해 깊이 이해하는 계기가 되었습니다.